Word embeddings en TensorFlow Projector

Germán Rosati (CONICET / factor~data-EIDAES-UNSAM) · gefero en GitHub · código y archivos

¿Qué es word2vec?

word2vec es un método que aprende a representar cada palabra como un vector de números (acá, de 300) a partir de las palabras que aparecen a su alrededor en un texto grande. Las palabras que se usan en contextos parecidos terminan con vectores cercanos, y por eso se pueden medir similitudes y hasta hacer cuentas con significados (rey − hombre + mujer ≈ reina). Los dos embeddings de esta página se entrenaron con skip-gram y negative sampling (Mikolov et al., 2013).

Datos

Spanish Billion Words Corpus (SBWC)

Corpus de casi 1.500 millones de palabras en español, compilado por Cristian Cardellino.

  • 1.420.665.810 palabras, 46.925.295 oraciones, 3.817.833 tokens únicos.
  • Fuentes: Wikipedia, Wikisource y Wikibooks (2015), Europarl, documentos de la ONU, legislación de la UE, libros alineados, AnCora, SenSem y otros.
Los Simpsons

Diálogos de la serie, en inglés, del dataset The Simpsons Dataset de Kaggle.

  • Unas 150.000 líneas de diálogo de cerca de 600 episodios.
  • Se descartaron las líneas sin personaje asignado.

Procesamiento de cada embedding

SBWCE

El embedding lo entrenó Cardellino; este repositorio solo exporta un subconjunto.

  • Limpieza: se quitaron las etiquetas de los corpus anotados, los caracteres no alfanuméricos pasaron a espacios y los números se reemplazaron por DIGITO. No se modificaron las mayúsculas.
  • Entrenamiento: skip-gram con negative sampling (gensim), dimensión 300, frecuencia mínima 5, 20 palabras de ruido, con submuestreo de las palabras más frecuentes.
  • Resultado: 1.000.653 vectores. Se publican los de las 50.000 palabras más frecuentes.

Los Simpsons

  • Limpieza: se expandieron las contracciones, se quitó la puntuación y los dígitos, se pasó a minúsculas y se eliminaron las stopwords (NLTK, más «hey» y «ho»).
  • Lematización con WordNet: «burns» pasa a burn.
  • Bigramas: a cada línea se le agregaron sus bigramas (mr_burn, homer_simpson).
  • Entrenamiento: skip-gram con negative sampling (gensim), dimensión 300, ventana 2, frecuencia mínima 20, 20 palabras de ruido, submuestreo 0,00006, 50 épocas.
  • Resultado: 5.095 palabras, 1.369 de ellas bigramas. Se publican todas.

Ambos embeddings se convirtieron al formato del Projector con src/export_projector.py. Los vectores publicados tienen los mismos valores que los originales.

Explorarlos en TensorFlow Projector

Las figuras son proyecciones t-SNE en 2D hechas con src/make_figures.py, con algunas palabras resaltadas. No son capturas del Projector. Para explorar y buscar palabras, abrí los embeddings acá:

SBWCE (50.000 palabras)

Abrir en el Projector

Conviene empezar con PCA: T-SNE y UMAP tardan bastante con tantos puntos.

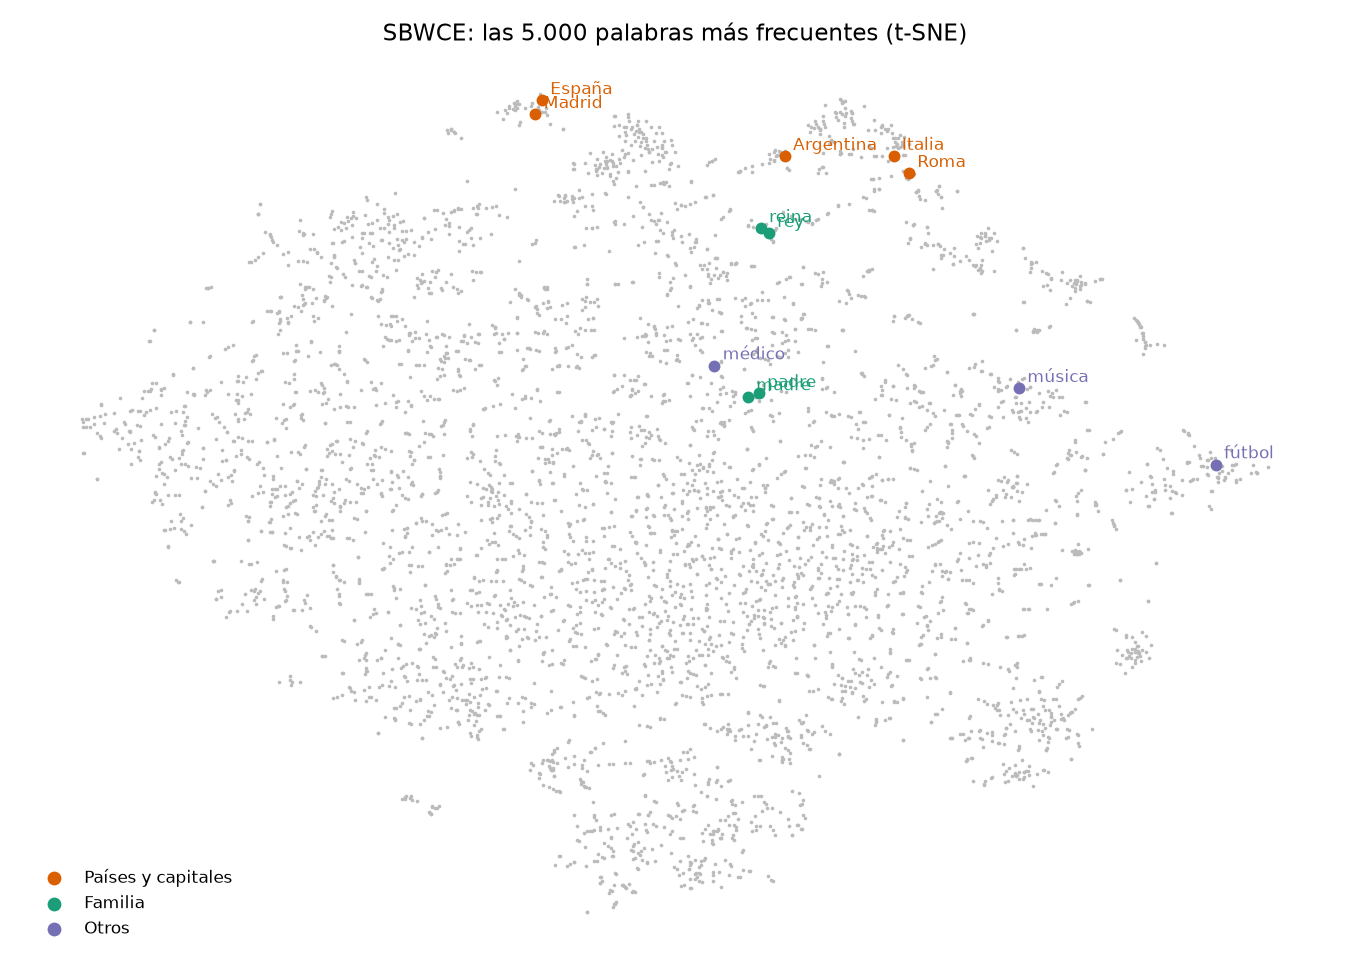
Proyección t-SNE en 2D de las 5.000 palabras más frecuentes del SBWCE, con países, capitales, términos de familia y otras palabras resaltadas
5.000 palabras más frecuentes del SBWCE. Los países y capitales y los términos de familia quedan agrupados.

Los Simpsons (5.095 palabras)

Abrir en el Projector

Con este tamaño, T-SNE y UMAP andan bien. Probá buscar moe o burn y mirar sus vecinos.

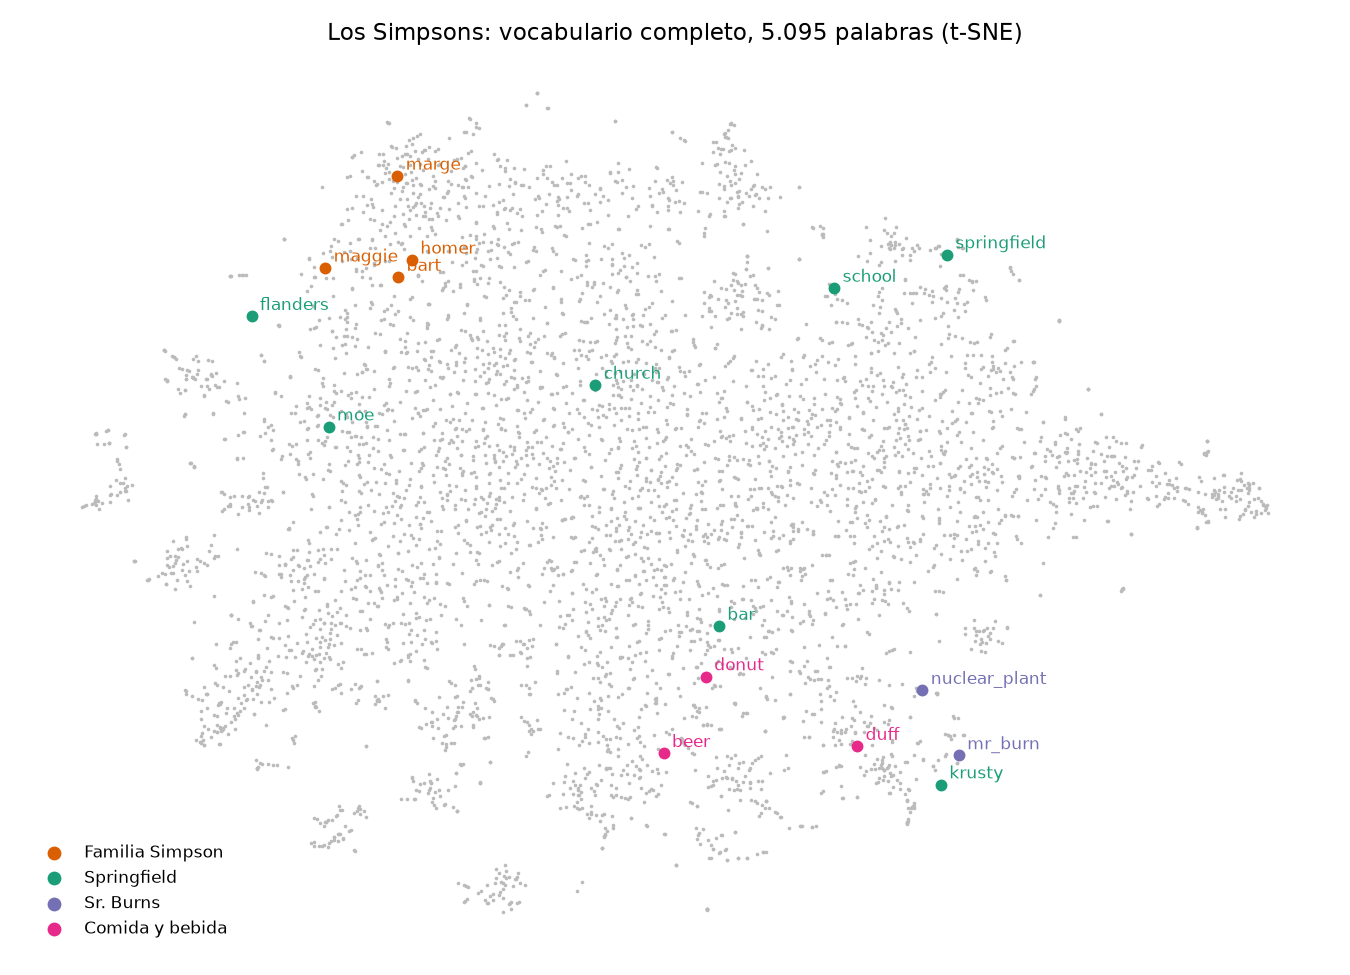
Proyección t-SNE en 2D del vocabulario completo de Los Simpsons, con los personajes de la familia, lugares de Springfield y comida resaltados
Vocabulario completo. Homer, Marge, Bart y Maggie quedan juntos.